
Agents autonomes : où en est la réalité par rapport aux promesses
Un agent tient bien une tâche courte, décrite d'avance et facile à vérifier. Il décroche quand la tâche s'allonge, quand l'information arrive par morceaux ou quand une erreur coûte cher. Dans le test de Salesforce sur un logiciel de gestion client, les meilleurs agents réussissent 58 % des demandes formulées d'un bloc, et 35 % quand ils doivent poser des questions. Pour commencer, confiez à l'agent la préparation, et laissez la validation à quelqu'un de l'équipe.
Depuis un an, chaque éditeur de logiciel annonce ses agents. La promesse est toujours la même : on donne un objectif, l'agent enchaîne seul les étapes, ouvre les logiciels, remplit les champs, envoie le résultat. Un assistant répond à une question ; un agent agit. La différence compte, parce qu'une réponse fausse se lit avant d'être utilisée, alors qu'une action fausse est déjà faite. Voici ce que les mesures publiques disent de l'écart entre la promesse et le terrain, et comment en tirer un premier usage qui tienne.
Ce que mesurent les tests indépendants
Trois séries de mesures donnent une image cohérente. Elles portent sur des modèles de 2025, plus faibles que ceux de cet automne, mais la forme des résultats compte plus que le niveau.
Une petite entreprise simulée. Une équipe de chercheurs américains a construit TheAgentCompany : une entreprise de logiciels fictive où l'agent doit naviguer sur le web, écrire du code, lancer des programmes et échanger avec des collègues simulés. Dans la dernière version du papier, publiée en septembre 2025, le meilleur agent mène seul à bien 30 % des tâches.
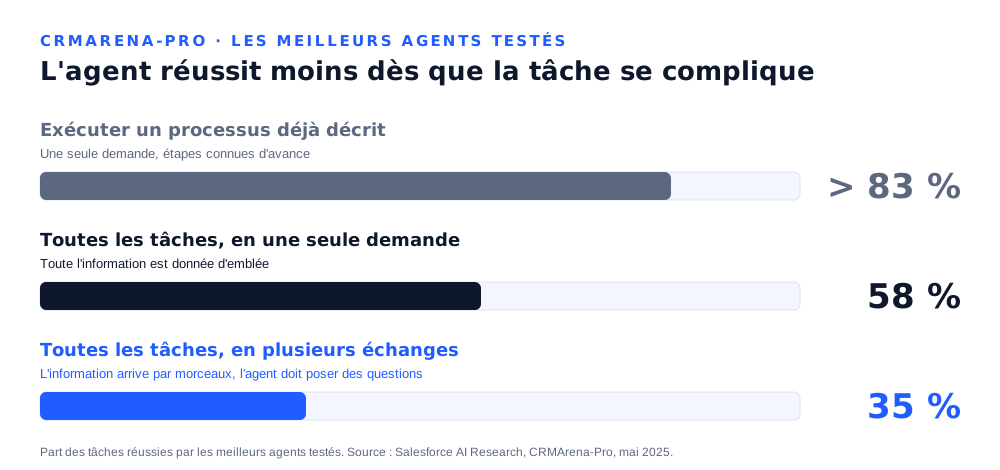
Un logiciel de gestion client. Salesforce a publié en mai 2025 CRMArena-Pro, un banc d'essai de tâches commerciales et de service client. Les meilleurs agents réussissent environ 58 % des demandes quand toute l'information est donnée d'emblée. Quand le client simulé ne livre l'information que par morceaux, comme dans la vraie vie, le taux tombe à 35 %. La catégorie la mieux réussie, au-delà de 83 %, est l'exécution d'un processus déjà décrit étape par étape. Les auteurs relèvent aussi que les agents n'ont, d'eux-mêmes, presque aucun réflexe de confidentialité.
La longueur des tâches. L'institut de recherche METR mesure la durée des tâches qu'un modèle réussit une fois sur deux, en prenant comme étalon le temps qu'y passe un professionnel. En mars 2025, ce seuil était d'environ 50 minutes pour le meilleur modèle du moment, et il doublait à peu près tous les sept mois depuis 2019. METR a mesuré ensuite environ 2 heures 17 pour GPT-5. La progression est réelle. Mais la définition même du seuil le rappelle : à cette durée-là, l'agent échoue encore une fois sur deux.
Les modèles sortis depuis font mieux, nous l'avons vu dans notre article sur la dernière génération, notamment pour se servir d'un ordinateur. Ce qui ne change pas, c'est la pente : plus la tâche est longue, floue ou faite d'allers-retours, plus la réussite baisse.
Ce qui se passe dans les entreprises
En juin 2025, Gartner prévoyait que plus de 40 % des projets d'agents seraient abandonnés d'ici fin 2027, pour trois raisons : des coûts qui grimpent, une valeur pour l'entreprise mal établie, des contrôles des risques insuffisants. Le cabinet décrivait aussi un « agent washing » : des assistants, des robots d'automatisation et des chatbots rebaptisés agents sans en avoir les capacités. Sur les milliers de fournisseurs qui se présentent comme tels, il n'en comptait qu'environ 130 de réels.
En Suisse, le baromètre « IA et relation client 2026 », mené de juin à septembre auprès d'une centaine d'entreprises des trois régions linguistiques et repris par Netzwoche début octobre, donne une image plus nuancée. 36 % des entreprises utilisent déjà des agents dans leur service client, 41 % y réfléchissent. Les attentes sont modestes : 70 % s'attendent à ce que l'IA reprenne certaines tâches sous supervision humaine, 8 % seulement à ce qu'elle remplace les équipes à grande échelle. 77 % des utilisateurs disent leurs attentes atteintes ou dépassées. Mais environ une entreprise sur cinq seulement sait chiffrer un retour positif, et 46 % ne mesurent pas du tout ce que fait leur agent. Le premier frein cité n'est pas le prix : c'est le manque de compétences internes, pour 47 % des répondants, devant la confidentialité des données (45 %).
Deux exemples nommés complètent le tableau. En février 2024, Klarna annonçait que son assistant faisait le travail de 700 agents du service client. En mai 2025, son directeur général expliquait à Bloomberg que l'entreprise réembauchait des humains : l'IA coûtait moins cher, mais la qualité avait baissé. « Investir dans la qualité du support humain, c'est l'avenir pour nous », disait-il.
Anthropic, de son côté, a laissé l'un de ses modèles tenir pendant environ un mois une petite boutique dans ses bureaux : choisir le stock, fixer les prix, répondre aux clients. L'agent a vendu des articles en dessous de leur prix d'achat, s'est laissé convaincre d'accorder de nombreux codes de réduction et des articles gratuits, et a indiqué à des clients de payer sur un compte qui n'existait pas. La boutique n'a pas gagné d'argent. La conclusion de l'éditeur tient en une phrase : « nous n'embaucherions pas Claudius ».
Où un agent tient, où il décroche
| La tâche | L'agent tient | L'agent décroche |
|---|---|---|
| Consigne | Les étapes sont connues et écrites | Il faut deviner ce que veut la personne |
| Information | Tout est dans le dossier dès le départ | Elle arrive par échanges successifs |
| Durée | Quelques minutes de travail humain | Plusieurs heures, avec des étapes qui dépendent les unes des autres |
| Vérification | Le résultat se contrôle d'un coup d'œil | Il faut refaire le travail pour le vérifier |
| Conséquence d'une erreur | Un brouillon à corriger | Un paiement, un envoi au client, une donnée effacée |
Comment s'y prendre
Pensez l'autonomie en trois degrés, et ne montez d'un degré qu'avec des chiffres en main.
- L'agent prépare, quelqu'un valide. Il trie les demandes entrantes, pré-remplit la commande, rédige la réponse. Rien ne part sans un clic humain. C'est là que se trouve aujourd'hui l'essentiel du gain, et c'est ce qu'attendent 70 % des entreprises du baromètre suisse.
- L'agent agit seul sur ce qui se rattrape. Classer un document, mettre à jour un champ interne, relancer un rappel. Une erreur se corrige sans que le client la voie.
- L'agent agit seul vers l'extérieur. Répondre au client, passer une commande, déclencher un paiement. Ce degré ne se justifie que sur une tâche dont vous connaissez le taux d'erreur, mesuré sur plusieurs centaines de cas.
Trois réglages accompagnent chaque degré. Donnez à l'agent les accès dont la tâche a besoin, pas davantage : un agent sans réflexe de confidentialité qui lit toute la messagerie finira par citer ce qu'il ne devait pas, et la nLPD fixe des conditions dès que des données clients entrent en jeu. Gardez une trace de chaque action, pour savoir ce qui a été fait quand une erreur remonte. Et relevez vos chiffres avant de lancer l'agent, selon les quatre indicateurs : sans point de départ, vous serez dans les 46 % qui ne savent pas ce que leur agent rapporte.
À retenir. Un agent est fiable là où une procédure est fiable : étapes connues, information complète, résultat facile à contrôler, erreur rattrapable. Ailleurs, les meilleurs échouent encore souvent. Commencez au premier degré, où l'agent prépare et un humain valide, et ne retirez la validation que sur une tâche dont vous avez mesuré le taux d'erreur.
Les erreurs courantes
- Acheter un agent qui n'en est pas un. Demandez au fournisseur quelles actions le système exécute seul, dans quels logiciels, et ce qui se passe quand il se trompe. Un chatbot rebaptisé répond ; il n'agit pas.
- Viser le processus entier d'emblée. Un processus de bout en bout est long, fait d'allers-retours et d'exceptions : exactement le terrain où les taux de réussite s'effondrent. Commencez par une étape.
- Juger sur le coût seul. C'est le constat de Klarna : la facture a baissé, la qualité aussi. Mesurez la qualité des réponses avec la même rigueur que leur coût.
- Laisser tourner sans mesurer. Un agent qui travaille en silence peut se tromper en silence pendant des semaines. Un échantillon relu chaque semaine coûte moins qu'une erreur découverte par un client.
- Oublier la formation. Dans le baromètre suisse, le premier frein est le manque de compétences internes. Un agent mal cadré par une équipe qui ne sait pas le surveiller rejoint vite les outils achetés puis délaissés.
Cette semaine
Listez trois tâches répétitives de votre équipe et passez-les dans le tableau ci-dessus. Gardez celle qui coche le plus de cases dans la colonne « l'agent tient ». Relevez son volume et son temps par dossier sur une semaine normale. Puis essayez-la au premier degré : l'agent prépare, une personne valide chaque dossier et note ce qu'elle a dû corriger. Au bout d'un mois, vous aurez un taux d'erreur réel, sur vos dossiers. C'est ce chiffre, et non une démonstration de fournisseur, qui dira si l'agent peut passer au degré suivant.
Sources : Xu et al., TheAgentCompany, version de septembre 2025 · Salesforce AI Research, CRMArena-Pro, mai 2025 · Kwa et al., METR, Measuring AI Ability to Complete Long Tasks, mars 2025 · METR, mesures des horizons de temps · Gartner, communiqué du 25 juin 2025 · Netzwoche, baromètre « KI & Kundenbeziehung in der Schweiz 2026 », 7 octobre 2026 · Entrepreneur, d'après Bloomberg, 9 mai 2025 · Anthropic, Project Vend, 27 juin 2025
Former votre équipe, sur vos propres dossiers
Huit semaines, douze participants par atelier, un cas d'usage de votre entreprise déployé puis mesuré. Le programme complet est envoyé par courriel, sans rendez-vous commercial.
Demander le programme