
Ce que la dernière génération de modèles change concrètement au travail de bureau
Entre le 22 septembre et le 8 octobre, Anthropic a sorti trois modèles et OpenAI a mis GPT-6 dans ChatGPT pour tout le monde. Trois choses changent vraiment : les modèles rendent des fichiers finis plutôt que du texte, ils savent se servir d'un ordinateur, et les petits modèles coûtent dix fois moins cher qu'il y a un an. Une chose ne change pas : la relecture. Dans l'étude de référence, elle fait passer le gain de temps de 90 fois à 1,12 fois.
À chaque sortie de modèle, la même question revient dans les directions : faut-il changer d'outil, refaire les essais, revoir le budget ? Cet automne, la question se pose avec plus de force que d'habitude, parce que les sorties se sont enchaînées en trois semaines et que les écarts annoncés sont grands. Voici ce qui est sorti, ce que les mesures disent vraiment, et ce que ça change pour une équipe administrative ou commerciale lundi matin.
Ce qui est sorti en trois semaines
- 22 septembre : Claude Opus 5.5, le haut de gamme de la nouvelle famille d'Anthropic, annoncé 40 % moins cher à faire tourner que son prédécesseur.
- 28 septembre : Claude Sonnet 5.5, le modèle intermédiaire, au même prix que Sonnet 5.
- 7 octobre : Claude Haiku 5.5, le petit modèle destiné aux gros volumes.
- 7 et 8 octobre : GPT-6 arrive dans ChatGPT, en version Sol pour les abonnements payants (Plus, Pro, Business, Enterprise), en version Luna pour les comptes gratuits. OpenAI précise que seul le chat change : les modèles de ChatGPT Work et de Codex restent les mêmes pour l'instant.
Ce dernier point mérite qu'on s'y arrête. « Nous utilisons ChatGPT » ne dit plus quel modèle travaille réellement sur vos dossiers. Selon l'abonnement et l'endroit de l'application, ce n'est pas le même.
Ce que les mesures disent
La mesure la plus utile pour le travail de bureau s'appelle GDPval. OpenAI l'a publiée à l'automne 2025 : 1 320 tâches tirées du travail réel de professionnels de 44 métiers, avec en moyenne 14 ans d'expérience. On y demande des livrables complets : documents, tableurs, présentations. Des experts du métier comparent ensuite, sans savoir qui l'a produit, le livrable du modèle et celui d'un humain.
Depuis, l'institut indépendant Artificial Analysis fait passer 220 de ces tâches à chaque nouveau modèle, avec un accès à des fichiers et au web. Le classement se lit comme celui des échecs : plus le score est haut, plus le modèle gagne ses duels. Une réserve importante : ici, c'est un autre modèle qui arbitre les duels, pas un expert humain.
Sur ce classement, les trois premiers se tiennent dans la marge d'erreur : Claude Opus 5.5, Muse Wonder Full de Meta et Claude Sonnet 5.5. Le saut le plus parlant n'est pas en tête. Il est en bas de gamme. Le petit modèle d'Anthropic passe de 735 points pour Haiku 4.5 à 1 620 pour Haiku 5.5, et le modèle intermédiaire de 1 449 à 1 844. Le petit modèle d'aujourd'hui dépasse donc le modèle intermédiaire de la génération précédente.
Trois changements concrets
On reçoit des fichiers, plus seulement du texte
Les modèles de cet automne rendent un tableur avec ses formules, une présentation mise en page, un document structuré. Anthropic rapporte qu'un modèle de fusion-acquisition sous Excel accompagné d'une présentation pour la direction a pris 63 minutes à Opus 5.5, contre 93 à son prédécesseur. C'est un test interne de l'éditeur, à lire comme tel. Mais il dit où se situe le changement : on ne copie plus une réponse dans un document, on relit un document.
Le modèle se sert de l'ordinateur
OSWorld mesure la capacité d'un modèle à accomplir une tâche dans un vrai système d'exploitation : ouvrir un logiciel, remplir un formulaire, déplacer des fichiers. Selon les chiffres publiés par Anthropic, Haiku 4.5 réussissait 15,7 % des tâches, Haiku 5.5 en réussit 72,4 %. Sonnet passe de 57,0 % à 80,1 %, sur une variante un peu différente du test. Les tâches répétitives entre deux logiciels qui ne se parlent pas, recopier une commande d'un courriel vers un ERP par exemple, deviennent automatisables sans développement. Elles restent à surveiller de près, parce qu'une erreur s'y propage sans bruit.
Le petit modèle coûte dix fois moins cher
Haiku 5.5 est facturé USD 0,10 par million de jetons en entrée et USD 0,50 en sortie, contre USD 1 et USD 5 pour Haiku 4.5. La baisse vaut pour les demandes de moins de 100 000 jetons, c'est-à-dire l'essentiel des usages courants ; au-delà, le prix baisse de moitié. Pour trier des courriels entrants ou classer des factures fournisseurs, le calcul cesse d'être un poste à surveiller. Comme nous l'avons montré dans notre calcul sur une entreprise de vingt personnes, ce n'était déjà pas le poste principal. Le temps des gens l'est.
| Mesure | Génération précédente | Cet automne | Source |
|---|---|---|---|
| Livrables de bureau (GDPval-AA, points) | Haiku 4.5 : 735 Sonnet 5 : 1 449 |
Haiku 5.5 : 1 620 Sonnet 5.5 : 1 844 |
Artificial Analysis, chiffres repris par Anthropic |
| Usage de l'ordinateur (OSWorld, tâches réussies) | Haiku 4.5 : 15,7 % Sonnet 5 : 57,0 % |
Haiku 5.5 : 72,4 % Sonnet 5.5 : 80,1 % |
Anthropic, deux variantes du test |
| Prix du petit modèle (par million de jetons, entrée / sortie, demandes de moins de 100 000 jetons) | USD 1 / USD 5 | USD 0,10 / USD 0,50 | Anthropic |
| Modèle par défaut de ChatGPT | GPT-5.6 | GPT-6 (dans le chat seulement) | OpenAI |
Ce qui ne change pas : la relecture
Le papier GDPval contient un calcul que les annonces ne reprennent jamais. Sans compter la relecture, GPT-5 rendait ses livrables 90 fois plus vite qu'un expert et 474 fois moins cher. Les auteurs ont ensuite ajouté le temps qu'un professionnel passe à relire le travail du modèle et à le refaire quand il n'est pas bon. Le gain tombe à 1,12 fois en vitesse et 1,18 fois en coût. Si l'on laisse le modèle réessayer plusieurs fois avant de reprendre la main, il remonte à 1,39 fois et 1,63 fois. Ce sont les auteurs qui le résument : « quand on intègre le temps de relire et de refaire, le gain d'un modèle se réduit ».
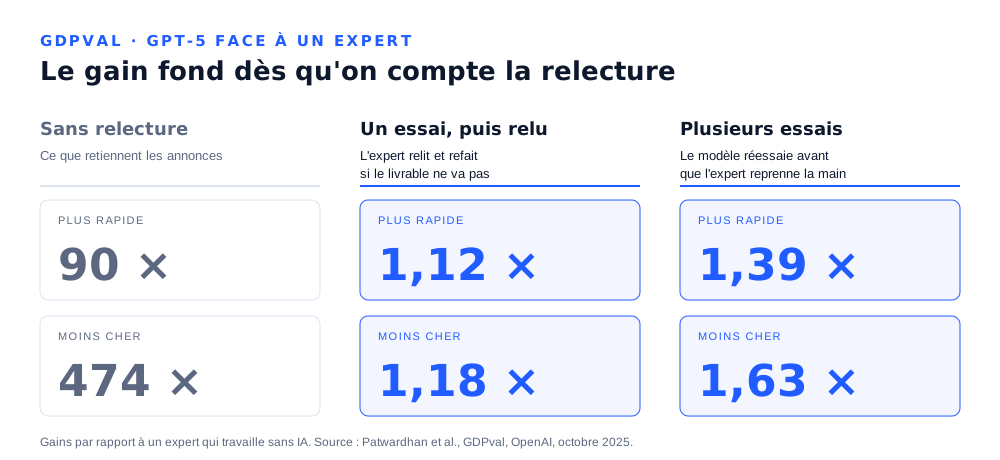
Ces chiffres datent d'un an et portent sur GPT-5. Les modèles de cet automne se trompent moins souvent, donc on refait moins, et le gain réel devrait être plus élevé. Personne n'a encore publié ce calcul pour eux. Ce que l'on sait, c'est pourquoi les experts préféraient le travail humain : le plus souvent, le modèle n'avait pas suivi toutes les consignes ou avait mal mis en forme, et tous les modèles inventaient parfois une donnée ou se trompaient dans un calcul.
La nouvelle génération ne fait pas disparaître ce risque. Anthropic indique que 16 rapports sur 18 rédigés par Opus 5.5 ne contenaient aucun chiffre ni aucune citation inventés, un niveau que ni Opus 5 ni Fable 5.1 n'avaient atteint. Lu dans l'autre sens, deux rapports sur dix-huit en contenaient encore. L'éditeur écrit lui-même que les écarts de classement sont un guide peu fiable des différences réelles. C'est pourquoi la relecture reste la compétence qui compte le plus : plus le modèle est bon, plus on est tenté de relire vite.
À retenir. La nouvelle génération produit des fichiers finis, se sert d'un ordinateur et coûte beaucoup moins cher en bas de gamme. Le gain que vous en tirerez ne dépend pas du classement : il dépend du temps que votre équipe met à vérifier ce que le modèle rend. Une tâche qu'on vérifie en deux minutes rapporte. Une tâche qu'il faut refaire pour la vérifier ne rapporte rien, quel que soit le modèle.
Les erreurs courantes
- Changer d'outil à chaque sortie. Les écarts en tête de classement tiennent dans la marge d'erreur. Changer de fournisseur coûte une nouvelle charte, de nouveaux réglages et des habitudes perdues, pour une différence que votre équipe ne verra souvent pas.
- Choisir sur un classement. Un score mesure des tâches précises, rédigées pour être claires. Les vôtres arrivent incomplètes, avec un contexte que personne n'a écrit. Seul un essai sur vos dossiers le dit.
- Ne pas refaire les essais ratés. Une tâche abandonnée au printemps parce que le résultat était mauvais mérite un nouvel essai. Le petit modèle d'aujourd'hui dépasse le modèle intermédiaire d'hier sur les livrables de bureau.
- Relâcher la relecture parce que le modèle est meilleur. Moins d'erreurs, ce sont des erreurs plus rares et donc plus difficiles à repérer. La règle de relecture de votre charte d'usage ne change pas avec la version.
Cette semaine
Ressortez la liste des tâches où l'IA avait été essayée puis écartée parce que le résultat ne tenait pas. Choisissez-en deux. Refaites l'essai sur cinq dossiers réels chacune, avec le modèle actuel, et chronométrez la relecture et les reprises comme le reste, selon la méthode des quatre indicateurs. Notez aussi quel modèle vous avez réellement utilisé : le nom de l'abonnement ne suffit plus. Si la vérification prend nettement moins de temps que le travail, la tâche entre dans vos usages. Sinon, vous saurez pourquoi, et vous referez l'essai à la prochaine génération.
Sources : Patwardhan et al., GDPval, OpenAI, octobre 2025 · Artificial Analysis, classement GDPval-AA v2.1, octobre 2026 · Anthropic, Claude Opus 5.5, 22 septembre 2026 · Anthropic, Claude Sonnet 5.5, 28 septembre 2026 · Anthropic, Claude Haiku 5.5, 7 octobre 2026 · OpenAI, déploiement de GPT-6 dans ChatGPT, 7 octobre 2026
Former votre équipe, sur vos propres dossiers
Huit semaines, douze participants par atelier, un cas d'usage de votre entreprise déployé puis mesuré. Le programme complet est envoyé par courriel, sans rendez-vous commercial.
Demander le programme